第十一章 神经网络与深度学习 Artificial Neural Newtork & Deep Learning
神经网络基本原理、梯度下降算法、BP反向传播、CNN、RNN
可能考:
(计算题)梯度下降算法:链式求导、反向传播
(计算题)CNN已知输入数据、卷积核参数求输出矩阵大小
11.1 人工神经网络 ANN
神经网络的历史

人工智能三大流派
符号主义 (symbolicism),又称为逻辑主义、心理学派或计算机学派,其原理主要为物理符号系统,即符号操作系统,假设和有限合理性原理。代表的有支持向量机(SVM),长短期记忆(LSTM)算法。
连接主义 (connectionism),又称为仿生学派或生理学派,其主要原理为神经网络及神经网络间的连接机制与学习算法 。
行为主义 (actionism),又称为进化主义或控制论学派 ,其原理为控制论及感知-动作型控制系统。
人工神经网络 ANN 的概念
人工神经网络(ANN,Artificial Neural Networks)是在人类对大脑神经网络认识理解的基础上,人工构造的能够实现某种功能的神经网络。
它是理论化的人脑神经网络的数学模型,是基于模仿大脑神经网络结构和功能而建立起来的一种信息处理系统。
神经元模型
人工神经网络通常呈现为相互连接的“神经元”,它可以从输入的计算值,并且能够机器学习以及模式识别由于它们的自适应性质的系统。
神经元和感知器一样,感受器由三部分组成:输入权值、激活函数和输出。
每次从训练数据中取出一个样本的输入向量,使用感知器计算其输出,再根据规则来调整权重。
神经网络结构
神经网络是按照一定规则连接起来 的多个神经元。包括:输入层、隐藏层、输出层。
第N层的每个神经元和第N-1层的所有神经元相连(全连接网络)。
每个连接都有一个权值。
-
输入层(Input layer),众多神经元(Neuron)接受大量非线形输入消息。
-
输出层(Output layer),消息在神经元链接中传输、分析、权衡,形成输出结果。
-
隐藏层(Hidden layer),简称“隐层”,是输入层和输出层之间众多神经元和链接组成的各个层面。
神经网络工作原理
神经网络是通过对人脑的基本单元——神经元的建模和联接,探索模拟人脑神经系统功能的模型,并研制一种具有学习、联想、记忆和模式识别等智能信息处理功能的人工系统。神经网络的一个重要特性是它能够从环境中学习,并把学习的结果分布存储于网络的突触连接中。神经网络的学习是一个过程,在其所处环境的激励下,相继给网络输入一些样本模式,并按照一定的规则(学习算法)调整网络各层的权值矩阵,待网络各层权值都收敛到一定值,学习过程结束。然后我们就可以用生成的神经网络来对真实数据做分类。
网络学习
代价函数
权重更新
对于每个突触上的权重,按照以下步骤进行更新:
- 将输入激励和响应误差相乘,从而获得权重的梯度;
- 将这个梯度乘上一个比例并取反后加到权重上。
- 这个比例将会影响到训练过程的速度和效果,因此称为“训练因子”。梯度的方向指明了误差扩大的方向,因此在更新权重的时候需要对其取反,从而减小权重引起的误差。
梯度下降
梯度下降思想
首先,我们有一个可微分的函数。这个函数就代表着一座山。我们的目标就是找到这个函数的最小值,也就是山底。根据之前的场景假设,最快的下山的方式就是找到当前位置最陡峭的方向,然后沿着此方向向下走,对应到函数中,就是找到给定点的梯度 ,然后朝着梯度相反的方向,就能让函数值下降的最快!因为梯度的方向就是函数之变化最快的方向。
所以,我们重复利用这个方法,反复求取梯度,最后就能到达局部的最小值,这就类似于我们下山的过程。
梯度下降算法:
- 梯度下降
- momentum
- AdaGrad
- RMSProp
- Adam
基本的梯度下降算法遵循的思想是,梯度的相反方向指向较低的区域。所以它在梯度的相反方向迭代。对于每个参数 θ\theta,它做如下操作:
θn=θn−1−α∇J(θ)\theta^n=\theta^{n-1}-\alpha\nabla J(\theta)\\
例1
J(θ)=θ2∇J(θ)=2θJ(\theta)=\theta^2 \\ \nabla J(\theta)=2\theta
例2
链式法则
求 e=(a+b)∗(b+1)e=(a+b)*(b+1) 的偏导
求出 a=2,b=1a=2, b=1 时,ee 的梯度
反向传播 BP
神经网络的反向传播 (BP, back propagation),逐层求出目标函数对各神经元权值的偏导数,构成目标函数对权值向量的梯量,作为修改权值的依据,网络的学习在权值修改过程中完成。误差达到所期望值时,网络学习结束。
链式求导
隐藏层
输入层
在每个参数偏导数明确的情况下,带入梯度下降公式即可
引入 δ\delta
可以将计算结果保存起来
传说的反向传播4大公式
常用的激活函数
Sigmoid
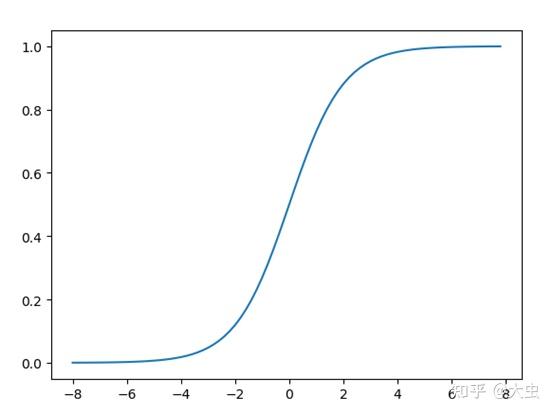
f(x)=11+e−xf(x)=\frac{1}{1+e^{-x}}
导数:
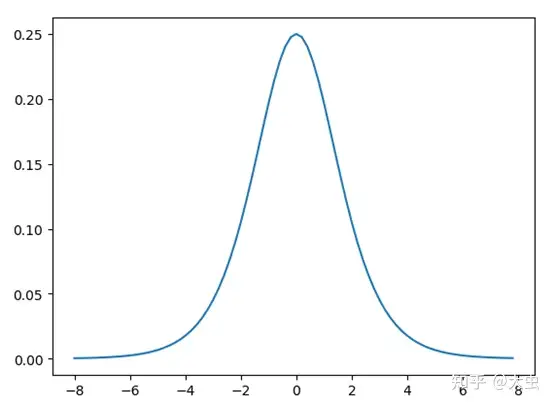
f′(x)=0−(−e−x)(1+e−x)2=11+e−x×(1−11+e−x)=f(x)(1−f(x))f^{'}(x)=\frac{0-(-e^{-x})}{(1+e^{-x})^{2}}=\frac{1}{1+e^{-x}}\times (1-\frac{1}{1+e^{-x}})=f(x)(1-f(x))
Softmax
f(xi)=exi∑j=1Nexjf(x_{i}) = \frac{e^{x_{i}}}{\sum_{j=1}^{N}{e^{x_{j}}}}
导数:
∂f(xi)∂xj=∂exi∂xj⋅∑j=1Nexj−exi⋅∂∑j=1Nexj∂xj(∑j=1Nexj)2\frac{\partial f(x_{i})}{\partial x_{j}}=\frac{\frac{\partial e^{x_{i}}}{\partial x_{j}}\cdot {\sum_{j=1}^{N}{e^{x_{j}}}}-e^{x_{i}}\cdot \frac{\partial{\sum_{j=1}^{N}{e^{x_{j}}}}}{\partial x_{j}}}{({\sum_{j=1}^{N}{e^{x_{j}}}})^{2}}
分两种情况:
(1) 当 i=ji=j 时:
∂f(xi)∂xj=exi⋅∑j=1Nexj−exi⋅exj(∑j=1Nexj)2=f(xi)(1−f(xj))\frac{\partial f(x_{i})}{\partial x_{j}}=\frac{e^{x_{i}}\cdot\sum_{j=1}^{N}{e^{x_{j}}}-e^{x_{i}}\cdot e^{x_{j}}}{(\sum_{j=1}^{N}{e^{x_{j}}})^{2}}=f(x_{i})(1-f(x_{j}))
(2) 当 i≠ji\ne j 时:
∂f(xi)∂xj=0⋅∑j=1Nexj−exi⋅exj(∑j=1Nexj)2=−f(xi)⋅f(xj)\frac{\partial f(x_{i})}{\partial x_{j}}=\frac{0\cdot\sum_{j=1}^{N}{e^{x_{j}}}-e^{x_{i}}\cdot e^{x_{j}}}{(\sum_{j=1}^{N}{e^{x_{j}}})^{2}}=-f(x_{i})\cdot f(x_{j})
Tanh
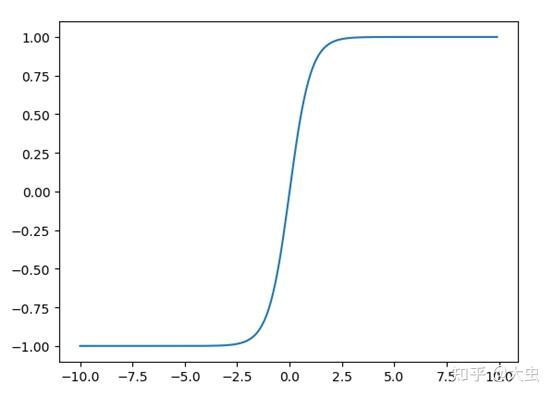
f(x)=ex−e−xex+e−xf(x)=\frac{e^{x}-e^{-x}}{e^{x}+e^{-x}}
导数:
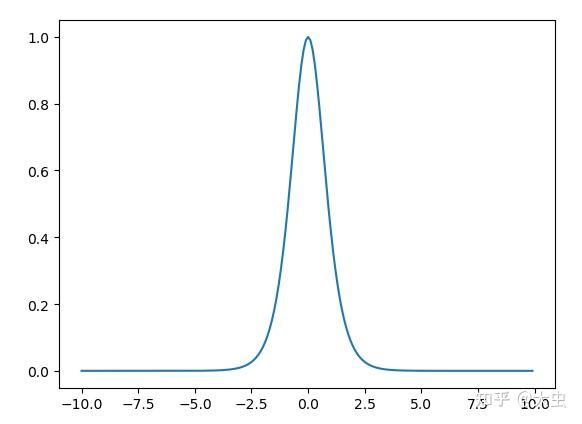
f′(x)=(ex+e−x)2−(ex−e−x)2(ex+e−x)2=1−f2(x)f^{'}(x)=\frac{(e^{x}+e^{-x})^{2}-(e^{x}-e^{-x})^{2}}{(e^{x}+e^{-x})^{2}}=1-f^{2}(x)
Relu
f(x)=max(0,x)f(x)=\max(0,x)
Relu函数是非平滑的,在0点不可导
f′(x)=0,x<=0f′(x)=1,x>0f^{'}(x)=0,x<=0 \\ f^{'}(x)=1,x>0
ANN 的优缺点
优点
- 预测精度总的来说较高
- 健壮性好,训练样本中包含错误时也可正常工作
- 输出可能是离散值、连续值或者是离散或量化属性的向量值
- 对目标进行分类较快
缺点
- 训练(学习)时间长
- 蕴涵在学习的权中的符号含义很难理解
- 很难根专业领域知识相整合
11.2 卷积神经网络 CNN
全连接网络的缺陷
(1)首先将图像展开为向量会丢失空间信息;
(2)其次参数过多效率低下,训练困难;
(3)同时大量的参数也很快会导致网络过拟合。
全连接神经网络之所以不太适合图像识别任务,主要有以下几个方面的问题:
- 参数数量太多
- 没有利用像素之间的位置信息
- 网络层数限制
CNN 的特性
卷积神经网络又是怎样解决这个问题的呢?主要有三个思路:
- 局部连接
- 权值共享
- 下采样
1)局部感知
图1:全连接网络。如果L1层有1000×1000像素的图像,L2层有1000,000个隐层神经元,每个隐层神经元都连接L1层图像的每一个像素点,就有1000x1000x1000,000=1012个连接,也就是1012个权值参数。
图2:局部连接网络。L2层每一个节点与L1层节点同位置附近10×10的窗口相连接,则1百万个隐层神经元就只有100万乘以100,即10^8个参数。其权值连接个数比原来减少了四个数量级。
2)权值共享
每一个颜色的线都有一个红色线的权值与之相等,所以第二层的每个节点,其从上一层进行卷积的参数都是相同的。
每种卷积核的参数不一样,表示它提出输入图像的不同特征(不同的边缘)。这样每种卷积核去卷积图像就得到对图像的不同特征的放映,我们称之为Feature Map,也就是特征图。
CNN 的结构
输入层
一张图片在计算机的眼里就是一个如下图所示的数字矩阵
将图像输入到CNN网络之前,通常我们会对其进行预处理,因为每个像素点的最大取值为255,因此将每个像素点的值除以 255 则可以将其归一化到[0,1]的范围。
隐含层
隐含层由卷积层、池化层和全连接层组成。
卷积层
卷积层的功能是对输入数据进行特征提取,其内部包含多个卷积核,组成卷积核的每个元素都对应一个权重系数和一个偏差量,类似于一个前馈神经网络的神经元。卷积层内每个神经元都与前一层中位置接近的区域的多个神经元相连,区域的大小取决于卷积核的大小,在文献中被称为“感受野”,其含义可类比视觉皮层细胞的感受野。卷积核在工作时,会有规律地扫过输入特征,在感受野内对输入特征做矩阵元素乘法求和并叠加偏差量
卷积层参数包括卷积核大小、步长和填充,三者共同决定了卷积层输出特征图的尺寸,是卷积神经网络的超参数。其中卷积核大小可以指定为小于输入图像尺寸的任意值,卷积核越大,可提取的输入特征越复杂。
卷积步长定义了卷积核相邻两次扫过特征图时位置的距离,卷积步长为1时,卷积核会逐个扫过特征图的元素,步长为n时会在下一次扫描跳过n-1个像素。
一维卷积
设f(x),g(x)是R上的两个可积函数,则卷积定义为:
(f∗g)(x)=∫−∞∞f(τ)g(x−τ)dτ(f*g)(x)=\int_{-\infty}^{\infty}f(\tau)g(x-\tau)d\tau
离散形式定义为:
(f∗g)(x)=∑τ=−∞∞f(τ)g(x−τ)(f*g)(x)=\sum\limits_{\tau=-\infty}^\infty f(\tau)g(x-\tau)
卷积例子
假设有两个骰子,f(x),g(x) 分别表示投两个骰子,x 面朝上的概率。
f(x)=g(x)={1/6x=1,2,3,4,5,60otherwisef(x)=g(x)=\begin{cases}1/6&x=1,2,3,4,5,6\\ 0&\text{otherwise}\end{cases}
卷积(f∗g)(x)表示投两个骰子,朝上数字之和为 x 的概率。则和为 4 的概率为:
(f∗g)(4)=∑τ=16f(τ)g(4−τ)=f(1)g(4−1)+f(2)g(4−2)+f(3)g(4−3)=1/6×1/6+1/6×1/6+1/6×1/6=1/12\begin{aligned} (f*g)(4)& =\sum_{\tau=1}^{6}f(\tau)g(4-\tau) \\ &=f(1)g(4-1)+f(2)g(4-2)+f(3)g(4-3) \\ &=1/6\times1/6+1/6\times1/6+1/6\times1/6 \\ &=1/12 \end{aligned}
二维卷积
处理的图像为一个二维的矩阵,卷积为
(f∗g)(x,y)=∑v=−∞∞∑h=−∞∞f(h,v)g(x−h,y−v)(f*g)(x,y)=\sum_{v=-\infty}^\infty\sum_{h=-\infty}^\infty f(h,v)g(x-h,y-v)
二维卷积例子
设f,g对应的概率矩阵如下
则(f∗g)(1,1)计算方式如下
(f∗g)(1,1)=∑v=02∑h=02f(h,v)g(1−h,1−v)(f*g)(1,1)=\sum_{v=0}^2\sum_{h=0}^2f(h,v)g(1-h,1-v)
(f∗g)(1,1) 即为f,g两个矩阵中对应颜色的元素乘积之和。
卷积核
在CNN中,f 为输入的图像,g 一般是一个相对较小的矩阵,我们称之为卷积核。这种情况下,卷积的计算方式是类似的,只是会将 g 矩阵旋转 180∘180^∘ 使得相乘的元素的位置也相同,同时需要 g 在 f 上进行滑动并计算对应位置的卷积值。
一些预设的卷积核对于图片可以起到不同的滤波器效果,例如下面4个卷积核分别会对图像产生不同的效果:不改变,边缘检测,锐化和高斯模糊。
卷积核两个参数和卷积核个数
CNN 网络中卷积层的两个常用参数padding和strides
padding 补零操作
padding是指是否对图像的外侧进行补零操作,其取值一般为VALID和SAME两种。
lVALID表示不进行补零操作,对于输入形状为(x,y)的矩阵,利用形状为(m,n)的卷积核进行卷积,得到的结果矩阵的形状则为(x-m+1,y-n+1)。
lSAME表示进行补零操作,在进行卷积操作前,会对图像的四个边缘分别向左右补充(m|2)+1个零。向上下补充(n|2)+1,| 表示整除
strides 卷积核
strides是指进行卷积操作时,每次卷积核移动的步长。示例中,卷积核在横轴和纵轴方向上的移动步长均为 1,除此之外用于也可以指定不同的步长。
filters 卷积核个数
filters其表示在一个卷积层中使用的卷积核的个数。在一个卷积层中,一个卷积核可以学习并提取图像的一种特征,但往往图片中包含多种不同的特征信息,因此我们需要多个不同的卷积核提取不同的特征。
三维卷积核:一个RGB图像(包含3个通道),相应的,卷积核也是一个3维的形状
池化层
池化层是一个利用池化函数(pooling function)对网络输出进行进一步调整的网络层。
池化函数使用某一位置的相邻输出的总体统计特征来代替网络在该位置的输出。
常用的池化函数包括最大池化(max pooling)函数(即给出邻域内的最大值)和平均池化(average pooling)函数(即给出邻域内的平均值) 等。
池化层同卷积层类似,具有三个比较重要的参数pool_size, strides, padding
pool_size=3, strides=3, padding=‘valid’
在卷积层进行特征提取后,输出的特征图会被传递至池化层进行特征选择和信息过滤。池化层包含预设定的池化函数,其功能是将特征图中单个点的结果替换为其相邻区域的特征图统计量。池化层选取池化区域与卷积核扫描特征图步骤相同,由池化大小、步长和填充控制。
全连接层
全链接层 (Fully-connected or Dense Layer) 的目的就是将我们最后一个池化层的输出连接到最终的输出节点上。
例如,最后一个池化层的输出大小为 [5×5×16],也就是有 5×5×16=400 个节点,对于手写数字识别的问题,我们的输出为0至9共10个数字,采用one-hot编码的话,输出层共10 个节点。
卷积神经网络中的全连接层等价于传统前馈神经网络中的隐含层。全连接层位于卷积神经网络隐含层的最后部分,并只向其它全连接层传递信号。特征图在全连接层中会失去空间拓扑结构,被展开为向量并通过激励函数。
按表征学习观点,卷积神经网络中的卷积层和池化层能够对输入数据进行特征提取,全连接层的作用则是对提取的特征进行非线性组合以得到输出,即全连接层本身不被期望具有特征提取能力,而是试图利用现有的高阶特征完成学习目标。
输出层
输出层根据具体问题的不同会略有不同,例如对于手写数字识别问题,采用one-hot编码的话,输出层则包含10个节点。
对于回归或二分类问题,输出层则仅包含1个节点。
当然对于二分类问题,我们也可以像多分类问题一样将其利用one-hot进行编码,例如[1,0]表示类型0,[0,1] 表示类型1。
CNN 的训练
和全连接神经网络相比,卷积神经网络的训练要复杂一些。但训练的原理是一样的:利用链式求导计算损失函数对每个权重的偏 导数(梯度),然后根据梯度下降公式更新权重。训练算法依然是反向传播算法。
CNN 的缺点
1.将固定大小的向量作为输入(比如一张图片),然后输出一个固定大小的向量(比如不同分类的概率)。
2.CNN还按照固定的计算步骤(比如模型中层的数量)来实现这样的输入输出。这样的神经网络没有持久性。假设你希望对电影中每一帧的事件类型进行分类,传统的神经网络就没有办法使用电影中先前的事件推断后续的事件。
几种典型的CNN结构
LeNet-5
LeNet-5 的网络架构:
AlexNet
AlexNet 在整体结构上同 LeNet-5 类似,其改进大致如下:
- 网络包含了5个卷积层和3个全连接层,网络规模变大。
- 使用了ReLU非线性激活函数。
- 应用了Data Augmentation,Dropout,Momentum,Weight Decay 等策略改进训练。
- 在算力有限的情况下,对模型进行划分为两部分并行计算。
- 增加局部响应归一化(LRN, Local Response Normalization)。
VGG Net
VGG Net 的主要改变如下:
- 网络层级更深,从AlexNet的8层增加至16层和19层。
- 仅使用3x3大小的卷积。在AlexNet中,浅层部分使用了较大的卷积核,而VGG使用了3x3的小卷积核进行串联叠加,减少了参数个数。
- 卷积采样的步长为1x1,Max Pooling的步长为2x2。
- 去掉了效果提升不明显的但计算耗时的LRN。
- 增加了Feature Maps的个数。
Network-in-Network
NIN网络的主要改变如下:
- 利用多层的全连接网络替换线性的卷积,即mlpconv (Conv + MLP)层。
- 去掉了全连接层,使用Global Average Pooling,也就是将每个Feature Maps上所有的值求平均,直接作为输出节点。
GoogLeNet (Inception V1,V3,V4)
随后 Google 在此对Inception进行了改进,同时提出了卷积神经网络的 4项设计原则,概括如下:
1.避免表示瓶颈,尤其是在网络的浅层部分。一般来说,在到达任务的最终表示之前,表示的大小应该从输入到输出缓慢减小。
2.高维特征在网络的局部更容易处理。在网络中增加更多的非线性有助于获得更多的解耦特征,同时网络训练也会加快。
3.空间聚合可以在低维嵌入中进行,同时也不会对表征能力带来太多影响。例如,再进行尺寸较大的卷积操作之前可以先对输入进行降维处理。
4.在网络的宽度和深度之间进行权衡。通过增加网络的深度和宽度均能够带来性能的提升,在同时增加其深度和宽度时,需要综合考虑算力的分配。
Residual Net
Deep Residual Net,在这个网络结构中,残差 (residual)的思想可以理解为:假设原始潜在的映射关系为H(x),对于新的网络层我们不再拟合原始的映射关系,而是拟合F(x)=H(x)-x,也就是说原始潜在的映射关系变为 F(x)+x。新的映射关系可以理解为在网络前向传播中添加了一条捷径 (shortcut connections),如下图所示:
DenseNet
综合比较
11.3 循环神经网络 RNN
为什么需要 RNN
他们都只能单独的取处理一个个的输入,前一个输入和后一个输入是完全没有关系的。但是,某些任务需要能够更好的处理序列的信息,即前面的输入和后面的输入是有关系的。
比如,当我们在理解一句话意思时,孤立的理解这句话的每个词是不够的,我们需要处理这些词连接起来的整个序列; 当我们处理视频的时候,我们也不能只单独的去分析每一帧,而要分析这些帧连接起来的整个序列。
RNN 的特点
RNN 是包含循环的网络,允许信息的持久化。
在自然语言处理(NLP)领域,RNN已经可以做语音识别、机器翻译、生成手写字符,以及构建强大的语言模型。
在机器视觉领域,RNN也非常流行。包括帧级别的视频分类,图像描述,视频描述以及基于图像的Q&A等等
RNN 的结构
神经网络的模块A读取某个输入 xtx_t,并输出一个值 yty_t,循环可以使得信息从当前步传递到下一步,将这个循环展开。
RNN 的公式
输入序列 x(1:T)=(x1,x2,…,xT)\textbf{x}_{(1:T)}=(\textbf{x}_1,\textbf{x}_2,\dots,\textbf{x}_T)
标记序列 y(1:T)=(y1,y2,...,yT)\textbf{y}_{(1:T)}=(\textbf{y}_1,\textbf{y}_2,...,\textbf{y}_T)
输出序列 y^(1:T)=(y^1,y^2,...,y^T)\hat{\textbf{y}}_{(1:T)}=(\hat{\textbf{y}}_1,\hat{\textbf{y}}_2,...,\hat{\textbf{y}}_T)
隐层输出 ht∈RH\textbf{h}_t\in\mathbb{R}^H
隐层输入 st∈RH\textbf{s}_t\in\mathbb{R}^H
过softmax之前输出层的输出 zt\textbf{z}_t
st=Uht−1+Wxt\mathbf{s}_t=U\mathbf{h}_{t-1}+W\mathbf{x}_t
ht=f(st)\mathbf{h}_t=f(\mathbf{s}_t)
zt=Vht\mathbf{z}_t=V\mathbf{h}_t
y^t=softmax(zt)\hat{\mathbf{y}}_t=\text{softmax}(\mathbf{z}_t)
ff 是激活函数,三个权重矩阵在时间维度上是共享的。
RNN 的训练算法
BPTT的基本原理和BP算法是一样的,同样是三步:
- 前向计算每个神经元的输出值;
- 反向计算每个神经元的误差项值,它是误差函数E对神经元j的加权输入的偏导数;
- 计算每个权重的梯度。
LSTM 的基本结构与思想
LSTM模型是用来解决simple RNN对于长时期依赖问题(Long Term Dependency),即通过之前提到的但是时间上较为久远的内容进行后续的推理和判断。
LSTM的基本思路是引入了门控装置,来处理记忆单元的记忆/遗忘、输入程度、输出程度的问题。
通过一定的学习,可以学到何时对各个门开启到何种程度,因为门控也是由有一定可以学习的参数的神经网络来实现的,这样就可以让机器知道何时应该记住某个信息,而何时应该抛弃某个信息。
RNN和LSTM的对比
LSTM的迭代公式
GRU 的结构和基本思想
GRU包含重置门(reset gate)和更新门(update gate)。重置门顾名思义,控制着是否重置,也就是说多大程度上擦除以前的状态state;更新门则表示,多大程度上要用candidate来更新当前的hidden layer。
GRU的基本原理
1.用 xtx_t 和 ht−1h_{t-1} 生成两个门;
2.用reset门乘以上一时刻的状态,看看是否要reset或者reset多大程度;
3.和新输入的x拼接,过网络并用tanh激活,形成candidate的隐含变量 h^t\hat{h}_t;
4.将上一时刻的h和candidate的h做一个线性组合,两者的权重和为1,candidate的权重就是update门的输出,表征更新强度多大。