第十二章 强化学习 Reinforcement Learning
强化学习基本原理、Q-learning
强化学习概述
什么是强化学习

强化学习(Reinforcement Learning, 简称 RL)是机器学习的范式和方法论之一,用于描述和解决智能体(Agent)在与环境(Environment)的交互过程中通过学习策略(Policy)以达成奖励或回报(Reward)最大化或实现特定目标的问题。
强化学习与其它机器学习算法的不同之处:
- 没有监督者以及标准答案,只有一个奖励信号;
- 环境的反馈是延迟的,不是立即生成的;
- 强化学习是序列学习,时间线很重要;
- 智能体的动作会影响后面所有的决策。
强化学习分类
强化学习主要涉及无模型(Model-Free)和有模型(Model-Based)两大类算法。
- Model-Free 算法可分为 Q-Learning 和基于策略优化(Policy Optimization)两大类。
- Model-Based 算法可分为模型学习(Learn the Model)和给定模型(Given the Model)两大类。
强化学习的任务
强化学习的任务对应一个四元组:
E=<X,A,P,R>E=<X,A,P,R>
- X:当前状态
- A:可采取的动作总体集合
- P:各个转移状态的概率值
- R:奖赏函数
整体的过程是,对于当前状态X,从动作集合A中选择一个动作,作用在X上,使得X按照概率转移函数P转移到另外一种状态,然后环境根据奖赏函数R对动作进行反馈。
强化学习在某种意义上可看作具有延迟标记信息的监督学习,它与监督学习不同,监督学习每个样本会有对应的标签,强化学习没有标签,而是执行完动作之后,通过反馈来判断执行动作是否正确。
马尔可夫决策过程 MDP
强化学习常用马尔可夫决策过程 (Markov Decision Process,MDP) 描述。
马尔可夫决策过程(Markov Decision Processes, MDPs)是一个智能体(Agent)采取行动(Action)从而改变自己的状态(State)获得奖励(Reward)与环境(Environment)发生交互的循环过程。
MDP
MDP 的策略完全取决于当前状态(Only present matters),这也是它马尔可夫性质的体现。
其可以简单表示为:
M=<S,A,Ps,a,R>M=<S,A,P_{s,a},R>
术语定义
有限状态 (state) 集合 SS,s∈Ss∈S,ss 表示某个特定状态。
有限动作 (action) 集合 AA,a∈Aa∈A,aa 表示某个特定动作。
转移模型 (Transition Model): T(S,a,S′)∼Pr(s′∣s,a)T(S,a,S') \sim Pr(s^′ |s,a):根据当前状态 ss 和动作 aa 预测下一个状态 s′s^′,这里的 PrPr 表示从 ss 采取行动 aa 转移到状态 s′s^′ 的概率。
奖励 (Reward) R(s,a)=E[Rt+1∣s,a]R(s,a)=E[R_{t+1} |s,a]:表示 agent 采取某个动作后的即时奖励,他还有 R(s,a,s′)R(s,a,s'),R(s)R(s) 等表现形式,采用不同的形式,其意义略有不同。
策略 (Policy) π(s)→aπ(s)→a:根据当前 state 来产生 action,可表现为 a=π(s)a=π(s) 或 π(a│s)=P(a∣s)π(a│s)=P(a|s),后者表示某种状态下执行某个动作的概率。
回报与折扣率
回报(return)U(s0s1s2…)U(s_0 s_1 s_2…) 与折扣率(discount)γ∈[0,1]γ∈[0,1]:UU 代表执行一组 action 后所有状态累计的reward 之和,discount 系数 γγ 的目的在于使当下的 reward 比未来反馈的 reward 更重要。
U(s0s1s2⋯ )=∑t=0∞γtR(st)0≤γ<1≤∑t=0∞γtRmax=Rmax1−γ\begin{aligned} U(s_{0}s_{1}s_{2}\cdots)& =\sum_{t=0}^{\infty} \gamma^t R(s_t)\quad 0\leq\gamma<1 \\ &\le\sum_{t=0}^\infty\gamma^t R_{\max}=\frac{R_{\max}}{1-\gamma} \end{aligned}
强化学习的目的是最大化长期未来奖励,即寻找最大的 UU。
价值函数
价值函数用来衡量某一状态或动作-状态的优劣,即对智能体来说是否值得选择某一状态或在某一状态下执行某一动作。
状态价值函数:v(s)=E[Ut∣St=s]v(s)=E[U_t|S_t= s],意义为基于 tt 时刻的状态 ss 能获得的未来回报(return)的期望,加入动作选择策略后可表示为 vπ(s)=Eπ[Ut∣St=s]v_{\pi}(s)=E_{\pi}[U_t|S_t=s] (Ut=Rt+1+γRt+2+⋯+γT−t−1RTU_t=R_{t+1}+\gamma R_{t+2}+\cdots+\gamma^{T-t-1}R_T)
动作价值函数:qπ=Eπ[Ut∣St=s,At=a]q_{\pi}=E_{\pi}[U_t|S_t=s,A_t=a],意义为基于 tt 时刻的状态 ss,选择一个 action 后能获得的未来回报(return)的期望。
MDP 求解
找到最优的策略使未来回报最大化,求解过程大致可分为两步:
- 预测:给定策略,评估相应的状态价值函数和状态-动作价值函数。
- 行动:根据价值函数得到当前状态对应的最优动作。
贝尔曼 (Bellman) 期望方程
第一层的空心圆代表当前状态(state),向下连接的实心圆代表当前状态可以执行两个动作,第三层代表执行完某个动作后可能到达的状态 s′s'。
状态价值函数
vπ(s)=E[Ut∣St=s]=∑a∈Aπ(a∣s)(Rsa+γ∑s′∈SPss′avπ(s′))v_\pi (s)=E[U_t|S_t=s]=\sum_{a\in A}\pi(a|s)\left(R_s^a+\gamma\sum_{s'\in S}P_{s s'}^a v_{\pi}(s')\right)
其中, Pss′a=P(St+1=s′∣St=s,At=a)P_{ss'}^a=P(S_{t+1}=s'|S_t=s,A_t=a).
上式中策略 π\pi 是指给定状态 ss 的情况下,动作 aa 的概率分布,即 T(a∣s)=P(a∣s)T(a|s)= P(a|s).
将概率和转换为期望
vπ(s)=Eπ[Rsa+γvπ(St+1∣St=s)]v_\pi(s)=E_\pi[R_s^a+\gamma v_\pi(S_{t+1}|S_t=s)]
同理,动作价值函数的公式:
qπ(s,a)=Eπ[Rt+1+γqπ(St+1,At+1)∣St=s,At=a]q_{\pi}(s,a)=E_{\pi}[R_{t+1}+\gamma q_{\pi}(S_{t+1},A_{t+1})|S_t=s,A_t=a]
[v(1)⋮v(n)]=[R1⋮Rn]+γ[P11…P1n⋮P11…Pnn][v(1)⋮v(n)]\begin{bmatrix}v(1)\\ \vdots\\ v(n)\end{bmatrix}=\begin{bmatrix}\mathcal{R}_1\\ \vdots\\ \mathcal{R}_n\end{bmatrix}+\gamma\begin{bmatrix}\mathcal{P}_{11}&\dots&\mathcal{P}_{1n}\\ \vdots\\ \mathcal{P}_{11}&\dots&\mathcal{P}_{nn}\end{bmatrix}\begin{bmatrix}v(1)\\ \vdots\\ v(n)\end{bmatrix}
如上图,Bellman 方程也可以表达成矩阵形式:v=R+γPvv=R+\gamma Pv,可直接求出 v=(I−γP)−1Rv=(I-\gamma P)^{-1}R;其复杂度为O(n)O(n),一般可通过动态规划、蒙特卡洛估计与 Temporal-Difference learning 求解。
状态价值函数与动作价值函数的关系
vπ(s)=∑a∈Aπ(a∣s)qπ(s,a)=E[qπ(s,a)∣St=s]qπ(s,a)=Rsa+γ∑s′∈SPss′a∑a′∈Aπ(a′∣s′)qπ(s′,a′)=Rsa+γ∑s′∈SPss′avπ(s′)\begin{aligned} &v_{\pi}(s)=\sum_{a\in A}\pi(a|s)q_{\pi}(s,a)=E[q_{\pi}(s,a)|S_{t}=s] \\ &q_{\pi}(s,a)=R_{s}^{a}+\gamma\sum_{s^{\prime}\in S}P_{s s^{\prime}}^{a}\sum_{a^{\prime}\in A}\pi(a^{\prime}|s^{\prime})q_{\pi}(s^{\prime},a^{\prime})=R_{s}^{a}+\gamma\sum_{s^{\prime}\in S}P_{s s^{\prime}}^{a}v_{\pi}(s^{\prime}) \end{aligned}
最优方程
最优价值函数 (optimal state-value function)
v∗(s)=maxπvπ(s)q∗(s,a)=maxπqπ(s,a)v_*(s) =\max\limits_{\pi}v_{\pi}(s) \\ q_*(s,a) =\max\limits_{\pi}q_\pi(s,a)
其意义为所有策略下价值函数的最大值
Bellman 最优方程
v∗(s)=maxaq∗(s,a)=maxa(Rsa+γ∑s′∈SPss′av∗(s′))q∗(s,a)=Rsa+γ∑s′∈SPss′av∗(s′)=Rsa+γ∑s′∈SPss′amaxa′q∗(s′,a′)v_*(s)=\max\limits_{a}q_*(s,a)=\max\limits_{a}\left(R_s^a+\gamma\sum\limits_{s'\in S}P_{ss'}^a v_*(s')\right) \\ q_{*}(s,a)=R_{s}^{a}+\gamma\sum_{s^{\prime}\in S}P_{s s^{\prime}}^{a}v_{*}(s^{\prime})=R_{s}^{a}+\gamma\sum_{s^{\prime}\in S}P_{s s^{\prime}}^{a}\operatorname*{max}_{a^{\prime}}q_{*}(s^{\prime},a^{\prime})
vv 描述了处于一个状态的长期最优化价值,即在这个状态下考虑到所有可能发生的后续动作,并且都挑选最优的动作来执行的情况下,这个状态的价值。
qq 描述了处于一个状态并执行某个动作后所带来的长期最优价值,即在这个状态下执行某一特定动作后,考虑再之后所有可能处于的状态并且在这些状态下总是选取最优动作来执行所带来的长期价值。
BellMan 方程的近似求解方法
- Value Iteration
- Policy Iteration
- Q-learning
- Sarsa
Value Iteration & Policy Iteration
Value iteration 值迭代
最优化原理:当且仅当状态 ss 达到任意能到达的状态 s′s' 时,价值函数 vv 能在当前策略 (policy) 下达到最优,即 vπ(s′)=v∗(s′)v_\pi(s')=v_*(s'),与此同时,状态 ss 也能基于当前策略达到最优,即 vπ(s)=v∗(s)v_\pi(s)=v_*(s)。
状态转移公式为:
vk+1(s)=maxa∈A(Rsa+γ∑s′∈SPss′avk(s′))v_{k+1}(s)=\max\limits_{a\in A}(R_s^a+\gamma\sum\limits_{s'\in S}P_{ss'}^a v_k(s'))
矩阵形式为:
vk+1=maxa∈ARsa+γPavk\mathbf{v_{k+1}}=\max\limits_{a\in A}\mathbf{R_{s}^a}+\gamma\mathbf{P^a}\mathbf{v_{k}}
Value iteration 例子
状态空间 StateState:超级玛丽当前的坐标。
决策空间 ActionAction: 上、下、左、右四个动作。
Action 对 State 的影响和回报 P(State′,Reward∣State,Action)P(State',Reward|State, Action):本文认为该关系是已知的
- 超级玛丽每移动一步,reward=−1reward = -1;
- 超级玛丽得到宝箱,reward=0reward = 0 并且游戏结束。
初始化:所有state的价值V(s) = 0
第一轮迭代:对于每个state,逐一尝试上、下、左、右四个Action
记录Action带来的Reward、以及新状态V(s')
选择最优的Action,更新V(s) = Reward + V(s') = -1 + 0
第一轮结束后,所有状态都有V(s) = -1,即从当前位置出发走一步获得Reward=-1
第二轮迭代:对于每个state,逐一尝试上、下、左、右四个Action
记录Action带来的Reward、以及新状态 V(s')
选择最优的Action,更新V(s)=Reward+V(s')
对于宝箱周围的State,最优的Action是一步到达宝箱,V(s)=Reward+V(s')=-1+0
对于其他State,所有的Action都是一样的,V(s)=Reward+V(𝑠’)=(-1)+(-1)
第二轮结束后,宝箱周围的State的价值保持不变V(s)=-1,其他State的价值V(s)= -2
第三轮迭代:对于每个state,逐一尝试上、下、左、右四个Action
记录Action带来的Reward、以及新状态V(s')
选择最优的Action,更新V(s)=Reward+V(s')
对于宝箱周围的State,最优的Action是一步到达宝箱,V(s)=Reward+V(s')=-1+0
对于宝箱两步距离的State,最优的Action是先一步到达宝箱周边的State,V(s)= Reward+V(𝑠’)=(-1)+(-1)
对于宝箱三步距离的State,所有Action都一样,V(s)=Reward+V(𝑠′)=(-1)+(-2)
第四轮迭代:对于每个state,逐一尝试上、下、左、右四个Action
记录Action带来的Reward、以及新状态 V(s')
选择最优的Action,更新V(s) = Reward + V(s')
对于宝箱周围的State,最优的Action是一步到达宝箱,V(s)=Reward+V(s')=(-1)+0
对于宝箱两步距离的State,最优的Action是先一步到达宝箱周边的State,V(s)=Reward+V(s')=(-1)+(-1)
对于宝箱三步距离的State,最优的Action是所有Action都是一样的,V(s)=Reward+V(s')= (-1)+(-2)
Policy iteration 策略迭代
lterative Policy Evaluation: 基于当前的 Policy 计算出每个状态的 Value function
同步更新: 每次迭代更新所有的状态的 vv
Vk+1(s)=∑a∈Aπ(a∣s)(Rsa+γ∑s′∈SPss′avk(s′))V_{k+1}(s)=\sum\limits_{a\in A}\pi(a|s)\left(R_s^a+\gamma\sum\limits_{s'\in S}P_{ss'}^a v_k(s')\right)
矩阵形式:
vk+1=Rπ+γPπvk\mathbf{v^{k+1}}=\mathbf{R}^{\pi}+\gamma\mathbf{P}^{\pi}\mathbf{v^{k}}
Policy iteration 例子
初始化:随机选择一个策略作为初始值,比如说不管什么状态,一律朝下走,即P(Action=朝下走|State)=1,P(Action=其他Action|State)=0
第一步 策略评估(Policy Evaluation):根据当前的策略计算V(s)
第二步 策略提升(Policy Improvement):计算当前状态的最好Action,更新策略
π(s)=argmaxa∑s′,r(r+γV(s’))\pi(s)=\mathit{a r g m a x_{a}}\sum_{s^{\prime},r}(r+\gamma V(s’))
不停的重复策略评估和策略提升,直到策略不再变化为止
初始化:无论超级玛丽在哪个位置,策略默认为向下走
策略评估:计算V(s)
如果宝藏恰好在正下方,则期望价值等于到达宝藏的距离(-2或者-1)
如果宝藏不在正下方,则永远也不可能找到宝藏,期望价值为负无穷
策略提升:根据V(s)找到更好的策略
如果宝藏恰好在正下方,则策略已经最优,保持不变
如果宝藏不在正下方,根据 π(s)=argmaxa∑s′,r(r+γV(s’))\pi(s)=\mathit{a r g m a x_{a}}\sum_{s^{\prime},r}(r+\gamma V(s’)) 可以得出最优策略为横向移动一步
第一轮迭代:通过上一轮的策略提升,这一轮的策略变成了横向移动或者向下移动(如图所示)
策略评估:计算V(s)
如果宝藏恰好在正下方,则期望价值等于到达宝藏的距离(-2或者-1)
如果宝藏不在正下方,当前策略会选择横向移动,期望价值为-3, -2, -1
策略提升:根据V(s)找到更好的策略
如果宝藏恰好在正下方,则策略已经最优,保持不变
如果宝藏不在正下方,根据 π(s)=argmaxa∑s′,r(r+γV(s’))\pi(s)=\mathit{a r g m a x_{a}}\sum_{s^{\prime},r}(r+\gamma V(s’)) 可以得出当前策略已经最优,保持不变
Q-learning & SARSA
在线和离线算法 On and Off policy Learning
On-policy: Learn about policy π\pi from experience sampled from π\pi。
Off-policy: Learn about policy π\pi from experience sampled from μ\mu。
On-policy是指产生数据的策略与评估和要改善的策略是同一个策略。比如,agent 采用策略 π\pi 采样,得到了一些 episodes,然后就可以估算出 vv 值了,然后再利用 vv 值来改进这个策略。
Off-policy是指产生数据的策略与评估和改善的策略不是同一个策略。我们用 π\pi 表示用来评估和改进的策略,用 μ\mu 表示产生样本数据的策略。比如一个机器人可以通过学习其他机器人或者学习人类的做法来评估和改进自己的策略。
Sarsa是在线(On-policy)算法而Q-Learning是离线(Off-policy)算法。
Q-learning
Q-learning 由 Value iteration 演变而来,但去除了对 Transition Model 的依赖,因此属于 Model-free 的方法。
Q(st,at)←(1−α)Q(st,at)+α[rt+1+γmaxaQ(st+1,a)]Q(s_t,a_t)\leftarrow(1-\alpha)Q(s_t,a_t)+\alpha[r_{t+1}+\gamma\max\limits_{a}Q(s_{t+1},a)]
Q-Learning的目的是学习特定State下、特定Action的价值。是建立一个Q-Table,以State为行、Action为列,通过每个动作带来的奖赏更新Q-Table。
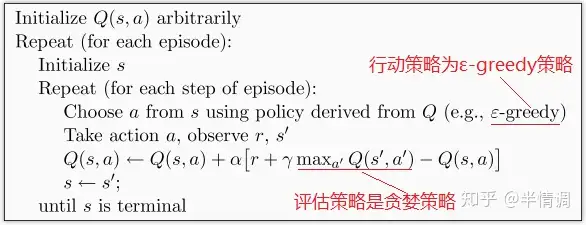
Q-Learning是off-policy的。异策略是指行动策略和评估策略不是一个策略。Q-Learning中行动策略是ε-greedy策略,要更新Q表的策略是贪婪策略。
SARSA
唯一与 Q-learning 的不同是,State-Action-Reward-State-Action (SARSA) 是 on-policy 方法,需要考虑 exporation-exploitation 问题,基本方法是 ϵ-greedy。
Q(st,at)←(1−α)Q(st,at)+α[rt+1+γQ(st+1,at+1)]Q(s_t,a_t)\leftarrow(1-\alpha)Q(s_t,a_t)+\alpha[r_{t+1}+\gamma Q(s_{t+1},a_{t+1})]
Sarsa全称是state-action-reward-state'-action'。 也是采用Q-table的方式存储动作值函数;而且决策部分和Q-Learning是一样的, 也是采用ε-greedy策略。不同的地方在于 Sarsa 的更新方式是不一样的。
1.Sarsa是on-policy的更新方式,它的行动策略和评估策略都是ε-greedy策略。
2.Sarsa是先做出动作后更新。
Q-Learning算法,先假设下一步选取最大奖赏的动作,更新值函数。然后再通过ε-greedy策略选择动作。
Sarsa算法,先通过ε-greedy策略执行动作,然后根据所执行的动作,更新值函数。
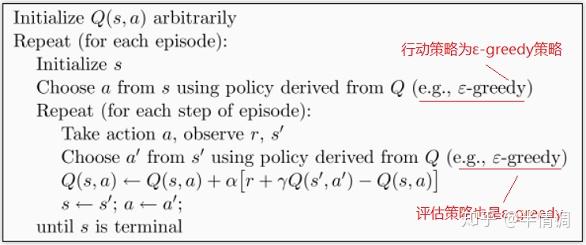
Q-learning 和 SARSA 对比
Q-learning更新公式:
最大的区别在于第8行,sarsa将本轮预测动作作为下轮epsilon-greedy的“利用”动作,Q-learning每轮根据新的的状态选动作。
Q-learning 例子
强化学习(七)--Q-Learning和Sarsa - 知乎 (zhihu.com)
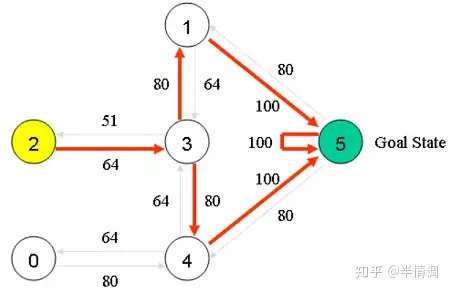
假设一栋建筑里有5个房间,房间之间通过门相连,将房间从0至4进行编号,且建筑外围可以认为是一个很大的房间,编号为5。
首先将Agent置于建筑中的任意一个房间,然后从那个房间开始,让其走到建筑外。为了将编号为5的房间设置为目标,我们为每一扇门关联一个reward值,直接连到目标房间的门的reward值为100,其他门的reward值为0。
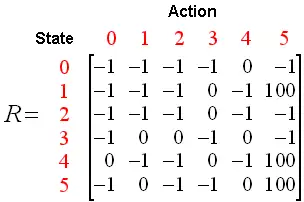
以状态为行,动作为列,构建一个关于reward值的矩阵R,其中-1表示空值。
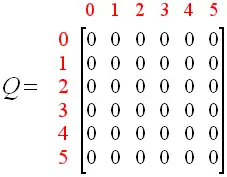
我们可以构建一个矩阵Q,用来表示Agent已经从经验中学到的知识,矩阵Q与R同阶,其行表示状态,列表示动作。由于刚开始时,agent对外界环境一无所知,因此矩阵Q应初始化零矩阵。在本例中状态数量是已知的,对于状态未知的情形,我们可以让Q从一个元素出发,每次发现一个新的状态时,就可以在Q中增加相应的行列。
算法转移规则:Q(s,a)=R(s,a)+γmax{Q(s′,a′)}Q(s,a)=R(s,a)+\gamma max \left\{ Q(s',a') \right\}
其中 s,as, a 表示当前的状态和动作,s′,a′s',a' 表示下一个状态及行为,折扣系数 γ∈[0,1]\gamma∈[0,1]。
Q-Learning算法是如何工作的?
首先令折扣系数为 γ=0.8\gamma=0.8 ,初始状态为房间1,并将Q初始化全零矩阵。
观察矩阵R的第二行(对应房间1或状态1),它包含两个非负值,即当前状态1的下一步行为有两个可能:转至状态3或状态5。随机转至状态5,更新 Q(1,5)Q(1,5) 。
Q(1,5)=R(1,5)+0.8×max{Q(5,1),Q(5,4),Q(5,5)}=100+0.8×0=100Q(1,5)=R(1,5)+0.8\times \max\left\{ Q(5,1),Q(5,4),Q(5,5) \right\}=100+0.8\times0=100
到达目标状态,一次episode完成,Q表更新。
在下一个 episode 中,随机选择3作为初始状态。
矩阵R的第四行: 它有3种可能的动作,进入状态1、2或4。随机选择状态1作为下一步的动作。
奖励矩阵R的第二行(对应状态 1),它有两种可能的动作: 进入状态3或状态5。
Q(3,1)=R(3,1)+0.8×max{Q(1,3),Q(1,5)}=0+0.8×max(0,100)=80Q(3,1)=R(3,1)+0.8\times \max\{Q(1,3),Q(1,5)\}=0+0.8\times \max(0,100)=80
执行更多次episode,矩阵Q最终收敛成
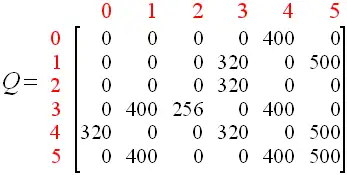
对其进行规范化,每个非零元素都除以矩阵Q的最大元素
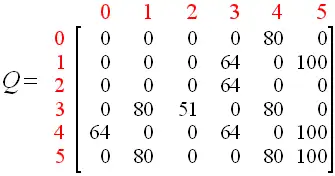
一旦矩阵足够接近收敛状态,Agent便学习到了转移至目标状态的最佳路径。
Q-Learning的思想完全根据值迭代得到。然而面对无限的状态、动作空间的实际应用问题,没办法遍历所有的状态和动作,得到各状态期望价值的准确估计,只能利用有限的样本数据来更新Q值。
Q(S,A)←Q(S,A)+α[R+γmaxaQ(S′,A)−Q(S,A)]Q(S,A)\leftarrow Q(S,A)+\alpha[R+\gamma max_{a}Q(S^{'},A)-Q(S,A)]
由于是有限的样本估计,没有直接将这个Q值(估计值)直接赋予新的Q值,而是采用渐进的方式类似梯度下降,朝目标更迈进一步,取决于α,这样能够减少估计误差造成的影响。类似梯度下降,最后可以收敛到最优的Q值。
上式可以看做:更新后的Q值=更新前的Q值+某种修正。